Inhalt7
- 01Die Verfahren in einer Chronologie
- 02Deutschland: Memorierung verurteilt, Datensatz bestätigt
- 03Europäische Union: ein erstes Verfahren vor dem Gerichtshof
- 04Frankreich: Die Nutzungsvermutung wartet auf die Abgeordneten
- 05Großbritannien und USA: zwei andere Logiken
- 06Was das für alle ändert, die veröffentlichen, und für alle, die generieren
- 07Häufige Fragen
Am 31. Juli 2026 hat das Landgericht München I der GEMA, der deutschen Verwertungsgesellschaft für Musikrechte, gegen Suno, einen KI-Musikgenerator, im Wesentlichen recht gegeben. Es war das zweite Urteil dieser Kammer gegen einen KI-Anbieter in neun Monaten, nach OpenAI im November 2025. Unterdessen kommen der Gerichtshof der EU, die US-amerikanischen Richter und das französische Parlament bei derselben Frage voran, jeder in seinem Tempo.
Dieser Überblick unserer Rubrik SEO und Sichtbarkeit in KI-Systemen zieht Bilanz zum 20. Oktober 2026. Er ist keine Rechtsberatung: Ein laufendes Verfahren kann in der Berufung eine andere Richtung nehmen, und Ihr Rechtsberater bleibt für einen konkreten Fall maßgeblich. Die Grundsatzdebatte, ob man die Urheber bezahlen muss, behandelt unsere Analyse zu KI und Urheberrecht.
Kurz gesagt
- In Deutschland haben zwei nicht rechtskräftige Urteile OpenAI und dann Suno wegen Werken verurteilt, die ihre Modelle memoriert oder wiedergegeben haben, und ein Oberlandesgericht hat die Erstellung eines Trainingsdatensatzes für zulässig erklärt.
- Der Gerichtshof der EU hat am 10. März 2026 seine erste mündliche Verhandlung zu generativer KI und Urheberrecht abgehalten; die für den 3. September erwarteten Schlussanträge des Generalanwalts waren nach unserer Kenntnis am 20. Oktober nicht veröffentlicht.
- In Frankreich wurde die Vermutung der Werknutzung durch KI-Anbieter am 8. April 2026 vom Senat beschlossen, am 2. Juni im Ausschuss der Nationalversammlung angenommen und wartet auf die Plenarsitzung.
- In den USA wurde das Training 2025 in zwei Verfahren als „Fair Use“ eingestuft, nicht aber das Herunterladen von Raubkopie-Bibliotheken, das Anthropic 1,5 Milliarden Dollar gekostet hat.
Die Verfahren in einer Chronologie
- 6. März 2025
In Frankreich verklagen drei Organisationen von Autoren und Verlegern Meta vor dem Pariser Zivilgericht wegen des Trainings von Llama.
- 3. April 2025
Ein ungarisches Gericht legt dem Gerichtshof der EU das Verfahren Like Company gegen Google vor.
- Juni 2025
Zwei kalifornische Richter stufen das Training mit Büchern in den Verfahren gegen Anthropic und Meta als Fair Use ein.
- 4. November 2025
Der High Court in London weist die meisten Ansprüche von Getty Images gegen Stability AI ab.
- 11. November 2025
Das Landgericht München I gibt der GEMA gegen OpenAI recht.
- Dezember 2025
Das Oberlandesgericht Hamburg bestätigt die Rechtmäßigkeit des LAION-Datensatzes.
- 10. März 2026
Erste mündliche Verhandlung des Gerichtshofs zu generativer KI und Urheberrecht.
- 8. April 2026
Der französische Senat beschließt die Nutzungsvermutung für kulturelle Inhalte.
- 2. Juni 2026
Der Kulturausschuss der Nationalversammlung nimmt den Text an.
- 20. Juli 2026
Ein Bundesrichter genehmigt den Vergleich über 1,5 Milliarden Dollar zwischen Anthropic und Autoren.
- 31. Juli 2026
Das Landgericht München I gibt der GEMA gegen Suno recht.
Deutschland: Memorierung verurteilt, Datensatz bestätigt
Im Verfahren GEMA gegen OpenAI (42 O 14139/24) hat das Münchner Gericht entschieden, dass die Liedtexte von neun deutschen Songs, die in den Parametern der Modelle memoriert sind, eine nicht genehmigte Vervielfältigung darstellen, und ihre Wiedergabe in den Antworten von ChatGPT eine weitere, berichtet Conventus Law. Das Gericht räumt ein, dass das Training in der Regel unter die Schranke für Text- und Data-Mining fällt, nicht aber die Memorierung bestimmter Werke. OpenAI hat Berufung eingelegt; das Verfahren ist laut der Kanzlei Reed Smith beim Oberlandesgericht München anhängig.
Am 31. Juli 2026 hat dieselbe Kammer das Verfahren GEMA gegen Suno (42 O 763/25) entschieden. Laut Reed Smith hielt sie fest, dass die Memorierung von Werken in Modellen, die auf deutschen Servern gehostet werden, eine rechtswidrige Vervielfältigung ist, dass Suno und nicht seine Nutzer für die generierten Ergebnisse haftet und dass die Einhaltung des AI Act einen Anbieter nicht von der Einhaltung des Urheberrechts befreit. Wir lesen dieses Urteil über den Bericht von Reed Smith, nicht im Volltext, und es ist nicht rechtskräftig: Suno kann Berufung einlegen, und das Oberlandesgericht kann anders entscheiden, wie es auch im Fall OpenAI entscheiden wird.
Das Verfahren Kneschke gegen LAION geht in die andere Richtung, bei einem anderen Punkt. Im Dezember 2025 hat das Oberlandesgericht Hamburg (5 U 104/24) entschieden, dass die Erstellung eines Trainingsdatensatzes unter die Schranken für Text- und Data-Mining fällt, erklärt die Kanzlei Freshfields. Der in natürlicher Sprache formulierte Vorbehalt des Fotografen wurde zum Zeitpunkt des Herunterladens, 2021, nicht als maschinenlesbar angesehen. Eine Revision zum Bundesgerichtshof wurde zugelassen.
Europäische Union: ein erstes Verfahren vor dem Gerichtshof
Das Verfahren Like Company gegen Google (C-250/25) geht von einem ungarischen Presseverlag aus, der dem Chatbot Gemini vorwirft, umfangreiche Auszüge seiner Artikel angezeigt und ohne Genehmigung mit ihnen trainiert zu haben. Das Budapester Gericht stellt vier Fragen, zusammengefasst von der Kanzlei Stephenson Harwood: Ist die Anzeige eines teilweise identischen Textes eine öffentliche Wiedergabe, ist das Training eine Vervielfältigung, deckt die Schranke für Text- und Data-Mining es ab, und ist die auf Anfrage eines Nutzers generierte Antwort dem Anbieter zuzurechnen?
Die mündliche Verhandlung fand am 10. März 2026 statt, und die Schlussanträge des Generalanwalts wurden laut dem europäischen Helpdesk für geistiges Eigentum für den 3. September 2026 erwartet. Am 21. September waren laut EU Law Radar keine Schlussanträge vorgelegt worden, und wir haben am 20. Oktober keine Spur davon gefunden. Nach unserer Einschätzung ist ein Urteil vor 2027 unwahrscheinlich. Es wird für alle Gerichte der Union verbindlich sein, auch in der Berufung in München.
Frankreich: Die Nutzungsvermutung wartet auf die Abgeordneten
Der am 12. Dezember 2025 im französischen Senat eingebrachte Gesetzentwurf schafft eine Vermutung: Ein geschütztes Werk gälte als von einem KI-System genutzt, sobald ein Indiz im Zusammenhang mit seiner Entwicklung, seinem Einsatz oder dem generierten Ergebnis diese Nutzung wahrscheinlich macht, fasst die Kanzlei Delsol zusammen. Die Beweislast ginge auf den Anbieter über.
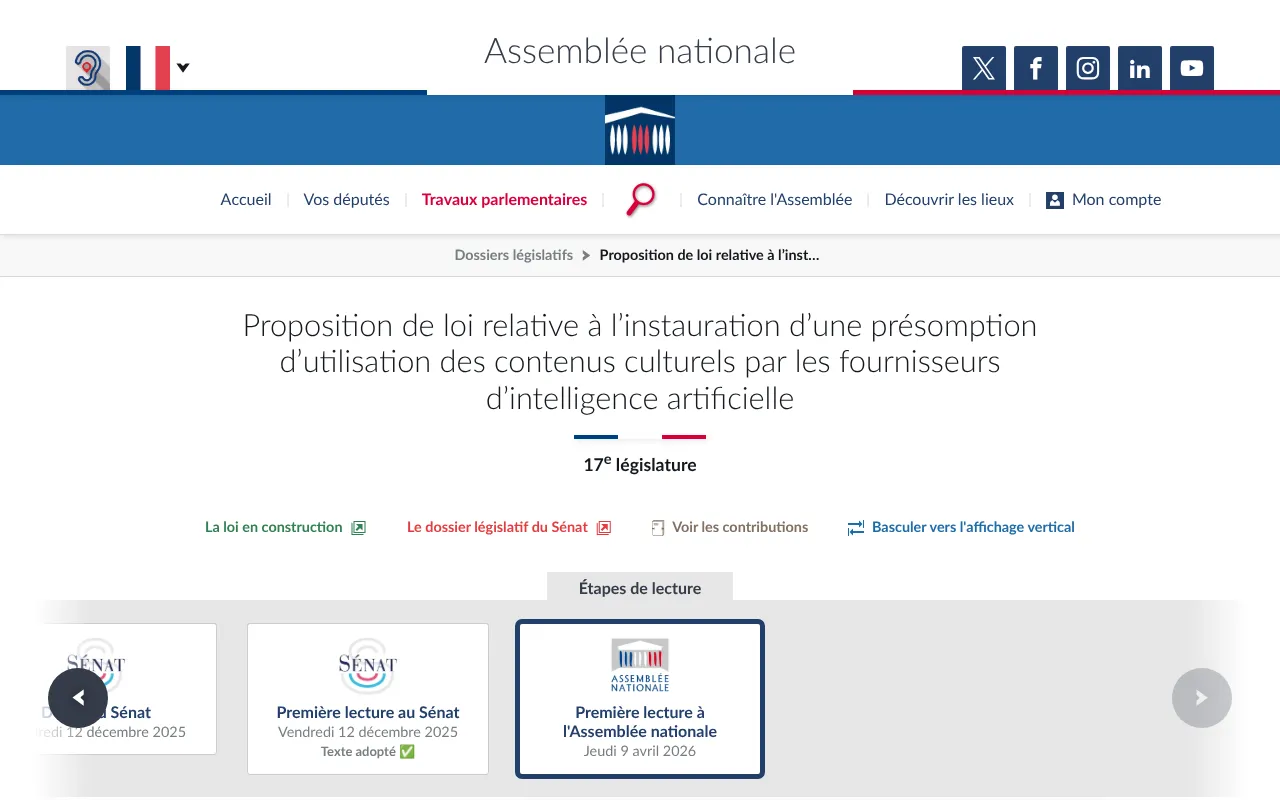
Das Dossier der Nationalversammlung: Der Text liegt seit dem 9. April 2026 den Abgeordneten in erster Lesung vor. Die Seite zeigt unter der Lesung im Senat dessen Einreichungsdatum, obwohl die Annahme vom 8. April stammt. Aufgenommen am 20. Oktober 2026.
Der französische Staatsrat (Conseil d’État) hat den nationalen Gesetzgeber für zuständig erklärt, diese Vermutung zu schaffen, teilte der Senat am 23. März 2026 mit. Die Senatoren haben den Text am 8. April angenommen; der Kulturausschuss der Nationalversammlung hat ihn seinerseits am 2. Juni angenommen, laut dem Gesetzgebungsdossier. Er muss nun im Plenum beraten werden, ohne dass am 20. Oktober ein Termin veröffentlicht war.
Auf Seiten der Gerichte ist die Klage des Syndicat national de l’édition, der Société des gens de lettres und des Syndicat national des auteurs et des compositeurs gegen Meta vom März 2025 laut der Verfahrensübersicht der Kanzlei CMS weiterhin anhängig; wir haben keine veröffentlichte Entscheidung gefunden.
Großbritannien und USA: zwei andere Logiken
In London hat der High Court am 4. November 2025 den Großteil der Klage von Getty Images gegen Stability AI abgewiesen: Die Gewichte des Modells speichern die Werke nicht und sind daher keine „infringing copy“ (rechtsverletzende Kopie), laut der Kanzlei Latham & Watkins. Getty hat die Zulassung der Berufung erhalten. Den politischen Kontext in Großbritannien, ohne Schranke für das kommerzielle Training, beschreibt unser Überblick zu Großbritannien.
In den USA haben zwei kalifornische Richter im Juni 2025 das Training von Modellen mit Büchern als „Fair Use“ eingestuft, aber einer von ihnen hat diese Einstufung für den Aufbau einer Bibliothek aus Raubkopien verweigert, erinnert die Kanzlei White & Case. Dieses Verfahren, Bartz gegen Anthropic, endete mit einem am 20. Juli 2026 genehmigten Vergleich:
Vergleich zwischen Anthropic und den Autoren, genehmigt vom Bundesgericht für Nordkalifornien
etwa pro Werk, nach der vom Gericht zugrunde gelegten Schätzung
Was das für alle ändert, die veröffentlichen, und für alle, die generieren
Für ein Unternehmen, das Inhalte veröffentlicht, kommt die konkreteste Lehre aus Hamburg: Ein Widerspruch gegen das Mining Ihrer Texte zählt nur, wenn eine Maschine ihn lesen kann. Ein Satz in Ihrem Impressum reicht möglicherweise nicht aus; eine robots.txt, die die KI-Crawler benennt, ist das gängigste Verfahren. Dazu muss man aber wissen, was Ihre Website tatsächlich ausliefert.
Aus der Praxis
Die ausgelieferte Datei war nicht die, die man glaubte
Bei einem SEO- und GEO-Audit am 22. Juli 2026 (interne Feststellung, an diesem Tag auf der geprüften Website erhoben) begann die tatsächlich ausgelieferte robots.txt mit einem vom CDN hinzugefügten Block, der im Code fehlte und GPTBot, ClaudeBot, Google-Extended, meta-externalagent und mehreren anderen KI-Crawlern die Website bereits untersagte. Niemand hatte das entschieden. Ein maschinenlesbarer Widerspruch kann bestehen, ohne dass Sie ihn gewählt haben, oder fehlen, obwohl Sie ihn für eingerichtet halten.
Die Wahl selbst, widersprechen oder lesen lassen, um zitiert zu werden, wird Crawler für Crawler getroffen: Wir erörtern die Bedingungen in wie man von ChatGPT zitiert wird, wozu eine llms.txt-Datei dient und Metas Bedingungen für das Crawlen von Websites.
Für ein Unternehmen, das Inhalte generiert, legen die Münchner Urteile die Verantwortung für die Ergebnisse auf den Anbieter des Modells, nicht auf den Nutzer, der die Frage stellt. Einen Text oder ein Bild zu veröffentlichen, das ein Werk wiedergibt, bleibt dennoch Ihre Veröffentlichung: Die menschliche Prüfung vor der Veröffentlichung, für die wir in muss man sagen, dass ein Text von einer KI geschrieben ist eintreten, dient auch dazu. Keine dieser Entscheidungen hebt einen KI-Anbieter als sicherer als die anderen hervor: Alle betreffen Nutzungen, keine Marken.
Die regulatorischen Fristen rund um diese Verfahren, darunter die Pflicht der Modellanbieter, Widersprüche zu beachten, finden Sie in unserem Kalender der digitalen Regulierung. Zu prüfen, was Ihre Website KI-Crawlern tatsächlich erlaubt, und zu entscheiden, was sie ihnen zeigen soll, ist der Umfang unseres Angebots SEO und GEO, und dieser Punkt gehört zu dem, was eine SEO-Agentur im KI-Zeitalter liefern muss.
Häufige Fragen
Hat ein europäisches Gericht bereits eine KI wegen Urheberrechtsverletzung verurteilt?
Ja, in erster Instanz: Das Landgericht München I hat der GEMA am 11. November 2025 gegen OpenAI und am 31. Juli 2026 gegen Suno recht gegeben, wegen Werken, die ihre Modelle memoriert und wiedergegeben haben. Keines dieser Urteile ist rechtskräftig: OpenAI hat Berufung eingelegt, und Suno kann es tun.
Kann man einer KI verbieten, mit der eigenen Website zu trainieren?
In Europa erlaubt die Richtlinie von 2019 dem Rechteinhaber, dem Mining seiner Inhalte zu widersprechen, wenn dies in angemessener Weise ausgedrückt wird, insbesondere bei Online-Inhalten mit maschinenlesbaren Mitteln. Das Oberlandesgericht Hamburg hat einen in natürlicher Sprache formulierten Vorbehalt verworfen. Die robots.txt ist das gängigste Mittel, Crawler für Crawler.
Ist die Vermutung der Werknutzung durch KI in Frankreich in Kraft?
Nein. Der Gesetzentwurf wurde am 8. April 2026 vom Senat und am 2. Juni 2026 vom Kulturausschuss der Nationalversammlung angenommen, muss aber noch von den Abgeordneten im Plenum beschlossen werden. Am 20. Oktober 2026 war kein Beratungstermin veröffentlicht.
Wann wird der Gerichtshof der EU das Verfahren Like Company gegen Google entscheiden?
Aller Voraussicht nach nicht vor 2027. Die mündliche Verhandlung fand am 10. März 2026 statt; die für den 3. September 2026 erwarteten Schlussanträge des Generalanwalts waren nach unserer Kenntnis am 20. Oktober nicht veröffentlicht. Das Urteil wird für alle Gerichte der Union gelten.
Quellen
- Conventus Law (neuer Tab)conventuslaw.com
- Der Kanzlei Reed Smith (neuer Tab)reedsmith.com
- Die Kanzlei Freshfields (neuer Tab)freshfields.com
- Der Kanzlei Stephenson Harwood (neuer Tab)stephensonharwood.com
- Dem europäischen Helpdesk für geistiges Eigentum (neuer Tab)intellectual-property-helpdesk.ec.europa.eu
- EU Law Radar (neuer Tab)eulawradar.com
- Die Kanzlei Delsol (neuer Tab)delsolavocats.com
- Teilte der Senat (neuer Tab)senat.fr
- Dem Gesetzgebungsdossier (neuer Tab)assemblee-nationale.fr
- Der Verfahrensübersicht der Kanzlei CMS (neuer Tab)cms.law
- Der Kanzlei Latham & Watkins (neuer Tab)lw.com
- Die Kanzlei White & Case (neuer Tab)whitecase.com
Dem europäischen Helpdesk für geistiges Eigentum
Auf intellectual-property-helpdesk.ec.europa.eu lesen(neuer Tab)Jim · Gründer von Brain Plus AI
Ebenfalls lesenswert zu seo und sichtbarkeit in ki
Verstehen9 Min.
Zeitplan AI Act und Digitalrecht: die Fristen 2026 bis 2028
AI Act, Data Act, Cyber Resilience Act, NIS2, elektronische Rechnungsstellung und die ersten US-Gesetze: alle Termine, die für ein Unternehmen zählen, vom Herbst 2026 bis August 2028, auf einer einzigen, laufend aktualisierten Seite. Zu jeder Frist: wer betroffen ist und was vorzubereiten ist.
Einordnen7 Min.
KI und Urheberrecht: Muss man die Urheber bezahlen?
Werke plündern oder lernen wie ein Leser? Das europäische Recht und ein erstes deutsches Urteil beginnen, Lernen und Memorieren zu trennen, und ein Herausgeber von Inhalten kann bereits wählen, dem Training zu widersprechen.
Praxisleitfaden7 Min.
Wie Sie von ChatGPT und KI-Suchmaschinen zitiert werden
Was wirklich dazu führt, dass eine Website von ChatGPT, Claude oder Perplexity zitiert wird: Robots lesen lassen, sofort antworten, Quellen angeben, nur Sichtbares auszeichnen. Und wie man es misst, ohne sich etwas vorzumachen.