Índice7
- 01Los procesos en una cronología
- 02Alemania: la memorización condenada, el conjunto de datos validado
- 03Unión Europea: un primer asunto ante el Tribunal de Justicia
- 04Francia: la presunción de uso espera a los diputados
- 05Reino Unido y Estados Unidos: otras dos lógicas
- 06Lo que cambia para quien publica y para quien genera
- 07Preguntas frecuentes
El 31 de julio de 2026, el Tribunal Regional de Múnich I dio la razón en lo esencial a la GEMA, la sociedad alemana de gestión de derechos musicales, contra Suno, un generador de música por IA. Era la segunda sentencia de esta sala contra un proveedor de IA en nueve meses, después de OpenAI en noviembre de 2025. Mientras tanto, el Tribunal de Justicia de la Unión, los jueces estadounidenses y el Parlamento francés avanzan, cada uno a su ritmo, sobre la misma cuestión.
Este repaso de nuestra sección de SEO y visibilidad en las IA hace balance a 20 de octubre de 2026. No es asesoramiento jurídico: un proceso en curso puede cambiar de sentido en apelación, y su asesor sigue siendo la referencia para un caso concreto. El debate de fondo, si hay que pagar a los autores, se trata en nuestro análisis sobre la IA y los derechos de autor.
En resumen
- En Alemania, dos sentencias no firmes han condenado a OpenAI y después a Suno por obras memorizadas o reproducidas por sus modelos, y un tribunal de apelación ha validado la creación de un conjunto de datos de entrenamiento.
- El Tribunal de Justicia de la Unión celebró el 10 de marzo de 2026 su primera vista sobre IA generativa y derechos de autor; las conclusiones del abogado general, esperadas para el 3 de septiembre, no estaban publicadas a nuestro conocimiento el 20 de octubre.
- En Francia, la presunción de uso de las obras por los proveedores de IA, votada en el Senado el 8 de abril de 2026, fue aprobada en comisión en la Asamblea Nacional el 2 de junio y espera el pleno.
- En Estados Unidos, el entrenamiento se consideró «uso legítimo» (fair use) en dos asuntos en 2025, pero no la descarga de bibliotecas pirateadas, que le costó 1 500 millones de dólares a Anthropic.
Los procesos en una cronología
- 6 de marzo de 2025
En Francia, tres organizaciones de autores y editores demandan a Meta ante el tribunal judicial de París por el entrenamiento de Llama.
- 3 de abril de 2025
Un tribunal húngaro plantea al Tribunal de Justicia de la Unión el asunto Like Company contra Google.
- Junio de 2025
Dos jueces de California califican de uso legítimo el entrenamiento con libros, en los asuntos contra Anthropic y Meta.
- 4 de noviembre de 2025
La High Court de Londres rechaza lo esencial de las pretensiones de Getty Images contra Stability AI.
- 11 de noviembre de 2025
El Tribunal Regional de Múnich I da la razón a la GEMA contra OpenAI.
- Diciembre de 2025
El tribunal de apelación de Hamburgo confirma la legalidad del conjunto de datos de LAION.
- 10 de marzo de 2026
Primera vista del Tribunal de Justicia sobre IA generativa y derechos de autor.
- 8 de abril de 2026
El Senado francés aprueba la presunción de uso de los contenidos culturales.
- 2 de junio de 2026
La comisión de asuntos culturales de la Asamblea Nacional aprueba el texto.
- 20 de julio de 2026
Un juez federal aprueba el acuerdo de 1 500 millones de dólares entre Anthropic y autores.
- 31 de julio de 2026
El Tribunal Regional de Múnich I da la razón a la GEMA contra Suno.
Alemania: la memorización condenada, el conjunto de datos validado
En el asunto GEMA contra OpenAI (42 O 14139/24), el tribunal de Múnich consideró que las letras de nueve canciones alemanas, memorizadas en los parámetros de los modelos, constituían una reproducción no autorizada, y que su reproducción en las respuestas de ChatGPT era otra, informa Conventus Law. El tribunal admite que el entrenamiento entra en general en la excepción de minería de textos y datos, pero no la memorización de obras concretas. OpenAI ha recurrido; el asunto está pendiente ante el tribunal de apelación de Múnich, según el despacho Reed Smith.
El 31 de julio de 2026, la misma sala resolvió el asunto GEMA contra Suno (42 O 763/25). Según Reed Smith, consideró que la memorización de obras en modelos alojados en servidores alemanes era una reproducción ilícita, que Suno, y no sus usuarios, respondía de los resultados generados, y que cumplir la Ley de IA (AI Act) no exime a un proveedor de respetar los derechos de autor. Leemos esta sentencia a través del resumen de Reed Smith, no en su texto íntegro, y no es firme: Suno puede recurrir, y el tribunal de apelación puede resolver de otro modo, como lo hará con OpenAI.
El asunto Kneschke contra LAION va en sentido contrario, sobre un punto distinto. En diciembre de 2025, el tribunal de apelación de Hamburgo (5 U 104/24) consideró que la creación de un conjunto de datos de entrenamiento entraba en las excepciones de minería de textos y datos, explica el despacho Freshfields. La reserva del fotógrafo, redactada en lenguaje natural, no se consideró legible por máquina en el momento de la descarga, en 2021. Se ha admitido un recurso de casación ante el Tribunal Federal de Justicia alemán.
Unión Europea: un primer asunto ante el Tribunal de Justicia
El asunto Like Company contra Google (C-250/25) parte de un editor de prensa húngaro, que reprocha al chatbot Gemini haber mostrado amplios extractos de sus artículos y haberse entrenado con ellos sin autorización. El tribunal de Budapest plantea cuatro preguntas, resumidas por el despacho Stephenson Harwood: ¿es la presentación de un texto parcialmente idéntico una comunicación al público, es el entrenamiento una reproducción, lo cubre la excepción de minería de textos, y es imputable al proveedor la respuesta generada a petición de un usuario?
La vista se celebró el 10 de marzo de 2026, y las conclusiones del abogado general se esperaban para el 3 de septiembre de 2026, según el servicio de asistencia europeo sobre propiedad intelectual. A 21 de septiembre, no se había presentado ninguna conclusión, según EU Law Radar, y no hemos encontrado rastro de ellas a 20 de octubre. Según nuestra estimación, la sentencia es poco probable antes de 2027. Se impondrá a todos los órganos jurisdiccionales de la Unión, incluida la apelación en Múnich.
Francia: la presunción de uso espera a los diputados
La proposición de ley presentada en el Senado francés el 12 de diciembre de 2025 crea una presunción: una obra protegida se consideraría utilizada por un sistema de IA en cuanto un indicio relacionado con su desarrollo, su despliegue o el resultado generado haga verosímil esa utilización, resume el despacho Delsol. La carga de la prueba pasaría al proveedor.
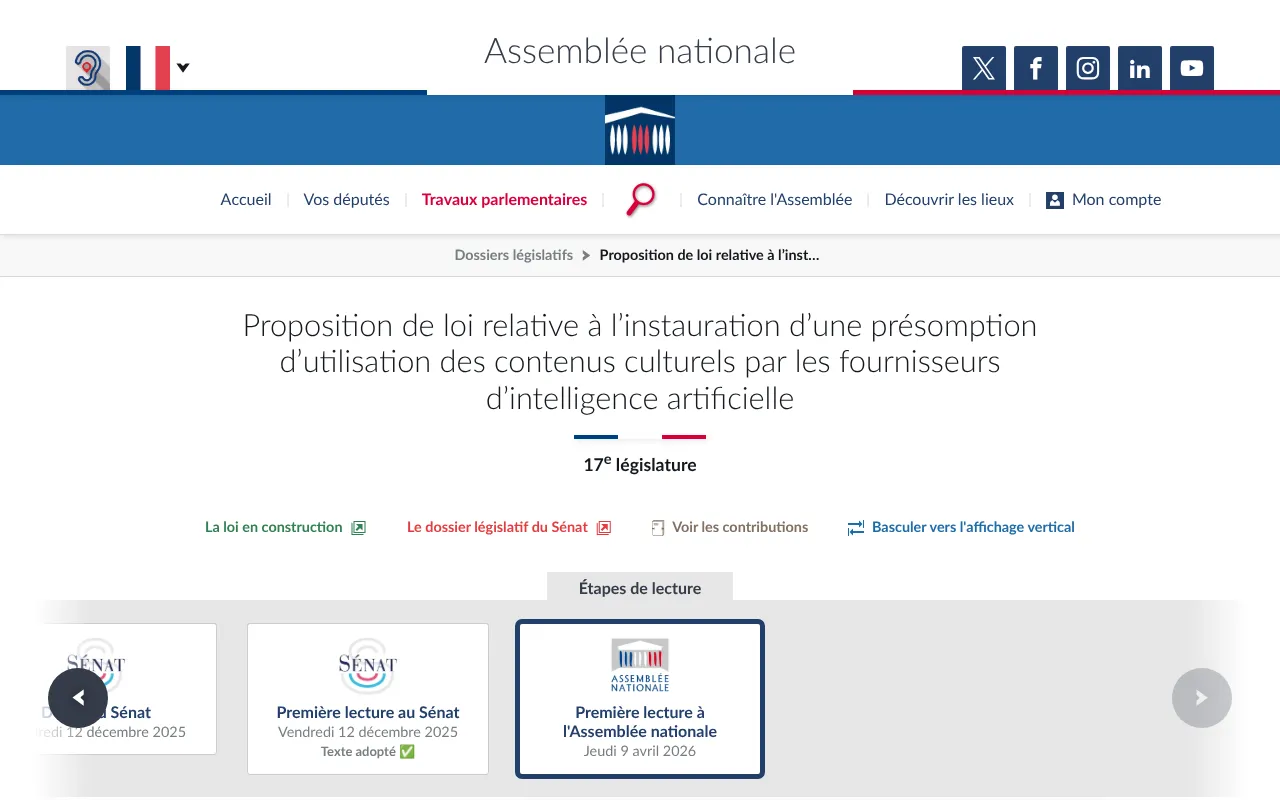
El expediente de la Asamblea Nacional: el texto está en primera lectura ante los diputados desde el 9 de abril de 2026. La página muestra bajo la lectura del Senado su fecha de presentación, aunque la aprobación es del 8 de abril. Capturada el 20 de octubre de 2026.
El Consejo de Estado francés consideró competente al legislador nacional para crear esta presunción, anunció el Senado el 23 de marzo de 2026. Los senadores aprobaron el texto el 8 de abril; la comisión de asuntos culturales de la Asamblea lo aprobó a su vez el 2 de junio, según el expediente legislativo. Ahora debe examinarse en pleno, sin fecha publicada a 20 de octubre.
En los tribunales, la demanda contra Meta del Syndicat national de l’édition, la Société des gens de lettres y el Syndicat national des auteurs et des compositeurs, de marzo de 2025, sigue pendiente según el seguimiento del despacho CMS; no hemos encontrado ninguna resolución publicada.
Reino Unido y Estados Unidos: otras dos lógicas
En Londres, la High Court rechazó el 4 de noviembre de 2025 lo esencial de la acción de Getty Images contra Stability AI: los pesos del modelo no almacenan las obras y, por tanto, no constituyen una «infringing copy» (copia infractora), según el despacho Latham & Watkins. Getty obtuvo autorización para recurrir. El contexto político británico, sin excepción para el entrenamiento comercial, se detalla en nuestro repaso sobre el Reino Unido.
En Estados Unidos, dos jueces de California calificaron en junio de 2025 de uso legítimo («fair use») el entrenamiento de modelos con libros, pero uno de ellos rechazó esa calificación para la creación de una biblioteca a partir de copias pirateadas, recuerda el despacho White & Case. Ese asunto, Bartz contra Anthropic, terminó con un acuerdo aprobado el 20 de julio de 2026:
de acuerdo entre Anthropic y los autores, aprobado por el tribunal federal del Norte de California
aproximadamente por obra, según la estimación adoptada por el tribunal
Lo que cambia para quien publica y para quien genera
Para una empresa que publica contenido, la lección más concreta viene de Hamburgo: una oposición a la minería de sus textos solo cuenta si una máquina puede leerla. Una frase en su aviso legal puede no bastar; un robots.txt que nombra los robots de IA es el procedimiento más habitual. Aún hace falta saber qué sirve realmente su sitio.
Sobre el terreno
El archivo servido no era el que se creía
Durante una auditoría SEO y GEO del 22 de julio de 2026 (constatación interna, registrada en el sitio auditado en esa fecha), el robots.txt realmente servido empezaba con un bloque añadido por la CDN, ausente del código, que ya prohibía el sitio a GPTBot, ClaudeBot, Google-Extended, meta-externalagent y varios otros robots de IA. Nadie lo había decidido. Una oposición legible por máquina puede existir sin que usted la haya elegido, o faltar cuando usted la cree vigente.
La elección en sí, oponerse o dejar leer para ser citado, se hace robot por robot: discutimos sus términos en cómo ser citado por ChatGPT, para qué sirve un archivo llms.txt y las condiciones de Meta sobre el rastreo de sitios.
Para una empresa que genera contenido, las sentencias de Múnich sitúan la responsabilidad de los resultados en el proveedor del modelo, no en el usuario que hace la pregunta. Publicar un texto o una imagen que reproduce una obra sigue siendo, sin embargo, su publicación: la revisión humana antes de publicar, que defendemos en hay que decir que un texto lo ha escrito una IA, sirve también para eso. Ninguna de estas resoluciones distingue a un proveedor de IA más seguro que los demás: todas tratan de usos, no de marcas.
Los plazos reglamentarios que rodean estos procesos, entre ellos la obligación de los proveedores de modelos de respetar las oposiciones, están en nuestro calendario de la regulación digital. Comprobar lo que su sitio autoriza realmente a los robots de IA y decidir lo que debe mostrarles es el alcance de nuestra oferta de SEO y GEO, y este punto forma parte de lo que una agencia SEO debe entregar en la era de la IA.
Preguntas frecuentes
¿Ha condenado ya un juez europeo a una IA por infringir los derechos de autor?
Sí, en primera instancia: el Tribunal Regional de Múnich I dio la razón a la GEMA contra OpenAI el 11 de noviembre de 2025 y contra Suno el 31 de julio de 2026, por obras memorizadas y reproducidas por sus modelos. Ninguna de estas sentencias es firme: OpenAI ha recurrido, y Suno puede hacerlo.
¿Se puede prohibir a una IA entrenarse con un sitio propio?
En Europa, la directiva de 2019 permite al titular de derechos oponerse a la minería de sus contenidos, expresada de manera adecuada, en particular mediante procedimientos legibles por máquina para los contenidos en línea. El tribunal de apelación de Hamburgo descartó una reserva redactada en lenguaje natural. El robots.txt es el medio más habitual, robot por robot.
¿Está en vigor en Francia la presunción de uso de las obras por las IA?
No. La proposición de ley fue aprobada por el Senado el 8 de abril de 2026 y por la comisión de asuntos culturales de la Asamblea el 2 de junio de 2026, pero todavía debe votarla en pleno la Asamblea Nacional. A 20 de octubre de 2026, no se había publicado ninguna fecha de examen.
¿Cuándo resolverá el Tribunal de Justicia de la Unión el asunto Like Company contra Google?
Con toda probabilidad, no antes de 2027. La vista tuvo lugar el 10 de marzo de 2026; las conclusiones del abogado general, esperadas para el 3 de septiembre de 2026, no se habían publicado a nuestro conocimiento el 20 de octubre. La sentencia valdrá para todos los órganos jurisdiccionales de la Unión.
Fuentes
- Conventus Law (nueva pestaña)conventuslaw.com
- El despacho Reed Smith (nueva pestaña)reedsmith.com
- El despacho Freshfields (nueva pestaña)freshfields.com
- El despacho Stephenson Harwood (nueva pestaña)stephensonharwood.com
- El servicio de asistencia europeo sobre propiedad intelectual (nueva pestaña)intellectual-property-helpdesk.ec.europa.eu
- EU Law Radar (nueva pestaña)eulawradar.com
- El despacho Delsol (nueva pestaña)delsolavocats.com
- Anunció el Senado (nueva pestaña)senat.fr
- El expediente legislativo (nueva pestaña)assemblee-nationale.fr
- El seguimiento del despacho CMS (nueva pestaña)cms.law
- El despacho Latham & Watkins (nueva pestaña)lw.com
- El despacho White & Case (nueva pestaña)whitecase.com
El servicio de asistencia europeo sobre propiedad intelectual
Leer en intellectual-property-helpdesk.ec.europa.eu(nueva pestaña)Jim · fundador de Brain Plus AI
Más artículos sobre seo y visibilidad en la ia
Entender11 min
Calendario del AI Act y del ámbito digital: plazos de 2026 a 2028
AI Act, Data Act, Cyber Resilience Act, NIS2, facturación electrónica y primeras leyes estadounidenses: todas las fechas que cuentan para una empresa, del otoño de 2026 a agosto de 2028, en una sola página actualizada. Para cada plazo, a quién afecta y qué hay que preparar.
Tomar perspectiva8 min
IA y derechos de autor: ¿hay que pagar a los autores?
¿Saquear las obras o aprender como un lector? El derecho europeo y una primera sentencia alemana empiezan a separar aprender y memorizar, y un editor de contenidos ya puede elegir oponerse al entrenamiento.
Guía práctica8 min
Cómo ser citado por ChatGPT y los motores de IA
Lo que realmente hace que ChatGPT, Claude o Perplexity citen un sitio: dejar leer a los robots, responder de inmediato, citar las fuentes, marcar solo lo que se muestra. Y cómo medirlo sin engañarse.