Sommaire7
- 01Les procédures en une chronologie
- 02Allemagne : la mémorisation jugée, le jeu de données validé
- 03Union européenne : une première affaire devant la Cour de justice
- 04France : la présomption d’utilisation attend les députés
- 05Royaume-Uni et États-Unis : deux autres logiques
- 06Ce que ça change pour qui publie, et pour qui génère
- 07Questions fréquentes
Le 31 juillet 2026, le tribunal régional de Munich I a donné raison pour l’essentiel à la GEMA, la société allemande de gestion des droits musicaux, contre Suno, un générateur de musique par IA. C’était le deuxième jugement de cette chambre contre un fournisseur d’IA en neuf mois, après OpenAI en novembre 2025. Pendant ce temps, la Cour de justice de l’Union, les juges américains et le Parlement français avancent, chacun à son rythme, sur la même question.
Ce point de notre rubrique SEO et visibilité dans les IA fait l’état des lieux au 20 octobre 2026. Ce n’est pas un conseil juridique : une procédure en cours peut changer de sens en appel, et votre conseil reste la référence pour un cas précis. Le débat de fond, faut-il payer les auteurs, est traité dans notre analyse sur l’IA et le droit d’auteur.
En bref
En Allemagne, deux jugements non définitifs ont condamné OpenAI puis Suno pour des œuvres mémorisées ou restituées par leurs modèles, et une cour d’appel a validé la constitution d’un jeu de données d’entraînement.
La Cour de justice de l’Union a tenu le 10 mars 2026 sa première audience sur l’IA générative et le droit d’auteur ; les conclusions de l’avocat général, attendues le 3 septembre, n’étaient pas publiées à notre connaissance au 20 octobre.
En France, la présomption d’utilisation des œuvres par les fournisseurs d’IA, votée au Sénat le 8 avril 2026, a été adoptée en commission à l’Assemblée le 2 juin et attend la séance.
Aux États-Unis, l’entraînement a été jugé « usage loyal » dans deux affaires en 2025, mais pas le téléchargement de bibliothèques piratées, qui a coûté 1,5 milliard de dollars à Anthropic.
Les procédures en une chronologie
- 6 mars 2025
En France, trois organisations d’auteurs et d’éditeurs assignent Meta devant le tribunal judiciaire de Paris pour l’entraînement de Llama.
- 3 avril 2025
Un tribunal hongrois saisit la Cour de justice de l’Union dans l’affaire Like Company contre Google.
- Juin 2025
Deux juges californiens qualifient d’usage loyal l’entraînement sur des livres, dans les affaires visant Anthropic et Meta.
- 4 novembre 2025
La High Court de Londres rejette l’essentiel des demandes de Getty Images contre Stability AI.
- 11 novembre 2025
Le tribunal régional de Munich I donne raison à la GEMA contre OpenAI.
- Décembre 2025
La cour d’appel de Hambourg confirme la légalité du jeu de données de LAION.
- 10 mars 2026
Première audience de la Cour de justice sur l’IA générative et le droit d’auteur.
- 8 avril 2026
Le Sénat adopte la présomption d’utilisation des contenus culturels.
- 2 juin 2026
La commission des affaires culturelles de l’Assemblée adopte le texte.
- 20 juillet 2026
Un juge fédéral approuve l’accord de 1,5 milliard de dollars entre Anthropic et des auteurs.
- 31 juillet 2026
Le tribunal régional de Munich I donne raison à la GEMA contre Suno.
Allemagne : la mémorisation jugée, le jeu de données validé
Dans l’affaire GEMA contre OpenAI (42 O 14139/24), le tribunal de Munich a jugé que les paroles de neuf chansons allemandes, mémorisées dans les paramètres des modèles, en constituaient une reproduction non autorisée, et que leur restitution dans les réponses de ChatGPT en était une autre, rapporte Conventus Law. Le tribunal admet que l’entraînement relève en général de l’exception de fouille de textes et de données, mais pas la mémorisation d’œuvres précises. OpenAI a fait appel ; l’affaire est pendante devant la cour d’appel de Munich, selon le cabinet Reed Smith.
Le 31 juillet 2026, la même chambre a jugé l’affaire GEMA contre Suno (42 O 763/25). Selon Reed Smith, elle a retenu que la mémorisation d’œuvres dans des modèles hébergés sur des serveurs allemands était une reproduction illicite, que Suno, et non ses utilisateurs, répondait des résultats générés, et que respecter l’AI Act ne dispense pas un fournisseur de respecter le droit d’auteur. Nous lisons ce jugement à travers le compte rendu de Reed Smith, pas dans son texte intégral, et il n’est pas définitif : Suno peut faire appel, et la cour d’appel peut juger autrement, comme elle le fera pour OpenAI.
L’affaire Kneschke contre LAION va dans l’autre sens, sur un point différent. En décembre 2025, la cour d’appel de Hambourg (5 U 104/24) a jugé que la constitution d’un jeu de données d’entraînement relevait des exceptions de fouille de textes et de données, explique le cabinet Freshfields. La réserve du photographe, rédigée en langage naturel, n’a pas été jugée lisible par machine au moment du téléchargement, en 2021. Un pourvoi devant la Cour fédérale de justice a été admis.
Union européenne : une première affaire devant la Cour de justice
L’affaire Like Company contre Google (C-250/25) part d’un éditeur de presse hongrois, qui reproche au chatbot Gemini d’avoir affiché de larges extraits de ses articles et de s’être entraîné sur eux sans autorisation. Le tribunal de Budapest pose quatre questions, résumées par le cabinet Stephenson Harwood : l’affichage d’un texte partiellement identique est-il une communication au public, l’entraînement est-il une reproduction, l’exception de fouille de textes le couvre-t-elle, et la réponse générée à la demande d’un utilisateur est-elle imputable au fournisseur ?
L’audience s’est tenue le 10 mars 2026, et les conclusions de l’avocat général étaient attendues le 3 septembre 2026, selon le service d’assistance européen sur la propriété intellectuelle. Au 21 septembre, aucune conclusion n’avait été rendue, selon EU Law Radar, et nous n’en avons pas trouvé trace au 20 octobre. Selon notre estimation, l’arrêt est peu probable avant 2027. Il s’imposera à toutes les juridictions de l’Union, y compris en appel à Munich.
France : la présomption d’utilisation attend les députés
La proposition de loi déposée au Sénat le 12 décembre 2025 crée une présomption : une œuvre protégée serait réputée utilisée par un système d’IA dès lors qu’un indice lié à son développement, à son déploiement ou au résultat généré rend cette utilisation vraisemblable, résume le cabinet Delsol. La charge de la preuve passerait au fournisseur.
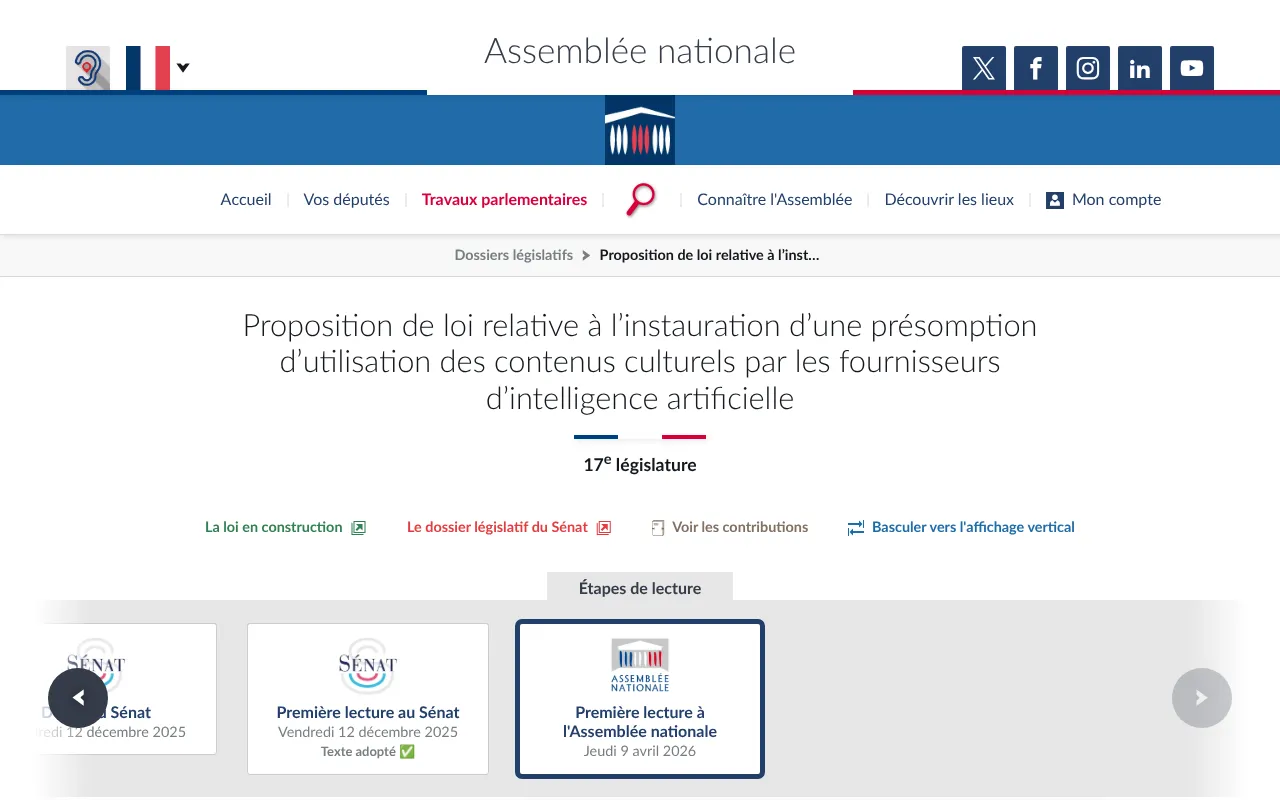
Le dossier de l’Assemblée nationale : le texte est en première lecture devant les députés depuis le 9 avril 2026. La page affiche sous la lecture du Sénat sa date de dépôt, alors que l’adoption date du 8 avril. Capturée le 20 octobre 2026.
Le Conseil d’État a jugé le législateur national compétent pour créer cette présomption, a annoncé le Sénat le 23 mars 2026. Les sénateurs ont adopté le texte le 8 avril ; la commission des affaires culturelles de l’Assemblée l’a adopté à son tour le 2 juin, selon le dossier législatif. Il doit maintenant être examiné en séance, sans date publiée au 20 octobre.
Côté tribunaux, l’assignation de Meta par le Syndicat national de l’édition, la Société des gens de lettres et le Syndicat national des auteurs et des compositeurs, en mars 2025, est toujours pendante d’après le suivi du cabinet CMS ; nous n’avons trouvé aucune décision publiée.
Royaume-Uni et États-Unis : deux autres logiques
À Londres, la High Court a rejeté le 4 novembre 2025 l’essentiel de l’action de Getty Images contre Stability AI : les poids du modèle ne stockent pas les œuvres et ne constituent donc pas une « copie contrefaisante », selon le cabinet Latham & Watkins. Getty a obtenu l’autorisation de faire appel. Le contexte politique britannique, sans exception pour l’entraînement commercial, est détaillé dans notre point sur le Royaume-Uni.
Aux États-Unis, deux juges californiens ont qualifié en juin 2025 d’usage loyal (« fair use ») l’entraînement de modèles sur des livres, mais l’un d’eux a refusé cette qualification pour la constitution d’une bibliothèque à partir de copies piratées, rappelle le cabinet White & Case. Cette affaire, Bartz contre Anthropic, s’est soldée par un accord approuvé le 20 juillet 2026 :
d’accord entre Anthropic et les auteurs, approuvé par le tribunal fédéral de Californie du Nord
environ par œuvre, selon l’estimation retenue par le tribunal
Ce que ça change pour qui publie, et pour qui génère
Pour une entreprise qui publie du contenu, la leçon la plus concrète vient de Hambourg : une opposition à la fouille de vos textes ne compte que si une machine peut la lire. Une phrase dans vos mentions légales risque de ne pas suffire ; un robots.txt qui nomme les robots d’IA est le procédé le plus courant. Encore faut-il savoir ce que votre site sert réellement.
Sur le terrain
Le fichier servi n’était pas celui qu’on croyait
Lors d’un audit SEO et GEO du 22 juillet 2026 (constat interne, relevé sur le site audité à cette date), le robots.txt réellement servi commençait par un bloc ajouté par le CDN, absent du code, qui interdisait déjà le site à GPTBot, ClaudeBot, Google-Extended, meta-externalagent et plusieurs autres robots d’IA. Personne ne l’avait décidé. Une opposition lisible par machine peut exister sans que vous l’ayez choisie, ou manquer alors que vous la croyez en place.
Le choix lui-même, s’opposer ou laisser lire pour être cité, se fait robot par robot : nous en discutons les termes dans comment être cité par ChatGPT, à quoi sert un fichier llms.txt et les conditions de Meta sur l’exploration des sites.
Pour une entreprise qui génère du contenu, les jugements de Munich placent la responsabilité des résultats sur le fournisseur du modèle, pas sur l’utilisateur qui pose la question. Publier un texte ou une image qui reproduit une œuvre reste pourtant votre publication : la relecture humaine avant mise en ligne, que nous défendons dans faut-il dire qu’un texte est écrit par une IA, sert aussi à ça. Aucune de ces décisions ne distingue un fournisseur d’IA plus sûr que les autres : toutes portent sur des usages, pas sur des marques.
Les échéances réglementaires qui entourent ces procédures, dont l’obligation pour les fournisseurs de modèles de respecter les oppositions, sont dans notre calendrier de la réglementation numérique. Pour vérifier ce que votre site autorise réellement aux robots d’IA et décider de ce qu’il doit leur montrer, c’est le périmètre de notre offre SEO et GEO, et ce point fait partie de ce qu’une agence SEO doit livrer à l’heure de l’IA.
Questions fréquentes
Un juge européen a-t-il déjà condamné une IA pour violation du droit d’auteur ?
Oui, en première instance : le tribunal régional de Munich I a donné raison à la GEMA contre OpenAI le 11 novembre 2025, puis contre Suno le 31 juillet 2026, pour des œuvres mémorisées et restituées par leurs modèles. Aucun de ces jugements n’est définitif : OpenAI a fait appel, et Suno peut le faire.
Peut-on interdire à une IA de s’entraîner sur son site ?
En Europe, la directive de 2019 permet au titulaire de droits de s’opposer à la fouille de ses contenus, exprimée de façon appropriée, notamment par des procédés lisibles par machine pour les contenus en ligne. La cour d’appel de Hambourg a écarté une réserve rédigée en langage naturel. Le robots.txt est le moyen le plus courant, robot par robot.
La présomption d’utilisation des œuvres par les IA est-elle en vigueur en France ?
Non. La proposition de loi a été adoptée par le Sénat le 8 avril 2026 et par la commission des affaires culturelles de l’Assemblée le 2 juin 2026, mais elle doit encore être votée en séance par les députés. Au 20 octobre 2026, aucune date d’examen n’était publiée.
Quand la Cour de justice de l’Union tranchera-t-elle l’affaire Like Company contre Google ?
Pas avant 2027 selon toute vraisemblance. L’audience a eu lieu le 10 mars 2026 ; les conclusions de l’avocat général, attendues le 3 septembre 2026, n’avaient pas été publiées à notre connaissance au 20 octobre. L’arrêt vaudra pour toutes les juridictions de l’Union.
Sources
- Conventus Law (nouvel onglet)conventuslaw.com
- Le cabinet Reed Smith (nouvel onglet)reedsmith.com
- Le cabinet Freshfields (nouvel onglet)freshfields.com
- Le cabinet Stephenson Harwood (nouvel onglet)stephensonharwood.com
- Le service d’assistance européen sur la propriété intellectuelle (nouvel onglet)intellectual-property-helpdesk.ec.europa.eu
- EU Law Radar (nouvel onglet)eulawradar.com
- Le cabinet Delsol (nouvel onglet)delsolavocats.com
- Annoncé le Sénat (nouvel onglet)senat.fr
- Le dossier législatif (nouvel onglet)assemblee-nationale.fr
- Le suivi du cabinet CMS (nouvel onglet)cms.law
- Le cabinet Latham & Watkins (nouvel onglet)lw.com
- Le cabinet White & Case (nouvel onglet)whitecase.com
Le service d’assistance européen sur la propriété intellectuelle
Lire sur intellectual-property-helpdesk.ec.europa.eu(nouvel onglet)Jim · fondateur de Brain Plus AI
À lire aussi en seo et visibilité dans les ia
Comprendre10 min
Calendrier AI Act et numérique : les échéances 2026 à 2028
AI Act, Data Act, Cyber Resilience Act, NIS2, facturation électronique et premières lois américaines : toutes les dates qui comptent pour une entreprise, de l'automne 2026 à août 2028, sur une seule page tenue à jour. Pour chaque échéance, qui est visé et ce qu'il faut préparer.
Prendre du recul8 min
IA et droit d'auteur : faut-il payer les auteurs ?
Piller les œuvres ou apprendre comme un lecteur ? Le droit européen et un premier jugement allemand commencent à séparer apprendre et mémoriser, et un éditeur de contenu peut déjà choisir de s'opposer à l'entraînement.
Guide pratique8 min
Comment être cité par ChatGPT et les moteurs IA
Ce qui fait vraiment qu'un site est cité par ChatGPT, Claude ou Perplexity : laisser lire les robots, répondre tout de suite, sourcer, baliser ce qui est affiché. Et comment le mesurer sans se raconter d'histoires.