Sommaire6
Le 30 octobre 2026, une nouvelle version des conditions commerciales de Meta entre en application pour toutes les entreprises qui utilisent ses outils professionnels : pages, publicités, gestionnaire d’entreprise. Mi-octobre, des juristes y ont lu une clause qui permet à Meta d’explorer les sites liés à ces comptes et d’en utiliser le contenu pour entraîner ses produits. Le 17 octobre, la presse a annoncé son retrait ; le lendemain, l’aperçu des conditions la contenait toujours.
Ce billet de notre rubrique SEO et GEO fait le point au 19 octobre 2026. Ce n’est pas un conseil juridique : pour un site dont le contenu est votre produit (presse, études, formation), faites lire les conditions par un avocat.
En bref
La version publiée mi-octobre autorise Meta à envoyer des robots sur les sites « associés à vos produits ou services » et à utiliser ce contenu pour entraîner ses produits.
Le 17 octobre, Meta a dit que ces règles d’exploration ne visaient que ses produits publicitaires et professionnels ; l’aperçu relu le 18 octobre contenait encore la phrase.
Continuer à utiliser les outils de Meta après le 30 octobre vaut acceptation des conditions.
Ce que vous maîtrisez : le texte que vous acceptez, et le fichier robots.txt que votre site sert réellement, robot par robot.
Que disent les nouvelles conditions commerciales de Meta ?
La version précédente des conditions commerciales, du 6 mars 2024, ne contenait aucune clause d’exploration. Celle qui s’applique au 30 octobre 2026 en ajoute une dans sa section 1 : l’entreprise autorise Meta, ou toute entité agissant pour son compte, à utiliser des logiciels automatisés (robots, araignées, agents utilisateurs) pour accéder aux domaines, pages ou adresses « associés à vos produits ou services », à créer des identifiants de test pour y accéder, et à en récupérer régulièrement les mises à jour, selon l’analyse du texte publiée par PPC Land. La phrase suivante est celle qui a fait réagir :
Meta peut utiliser tout contenu de ces domaines, pages web ou adresses pour fournir, développer, améliorer, étudier, entraîner et préserver l’intégrité de ses produits.
Trois juristes interrogés par Nieman Lab, dont James Grimmelmann (Cornell) et l’avocat Matt Topic, y ont vu un moyen pour Meta de soutenir que ce contrat prime sur les blocages d’un robots.txt, et les identifiants de test comme une façon de passer un mur d’inscription. Matt Topic résume : rien ne dit qu’un tribunal appliquerait la clause, mais les éditeurs devraient faire comme si.
Qu’est-ce qui a changé le 17 octobre ?
La séquence tient en quinze jours, et elle n’est pas close :
- 6 mars 2024
Version précédente des conditions commerciales, sans clause d’exploration.
- 15 octobre 2026
Nieman Lab publie la lecture de trois juristes.
- 16 octobre 2026
Andy Stone, porte-parole de Meta, qualifie ces lectures de « fausses » et assure que rien ne change dans l’usage des robots d’exploration.
- 17 octobre 2026
La presse rapporte que la phrase a disparu de la page des conditions ; Meta indique que ces règles ne valaient que pour ses produits publicitaires et professionnels, et qu’il l’a précisé dans le texte.
- 18 octobre 2026
L’aperçu de la version anglaise britannique, relu par PPC Land, contient toujours la phrase, sans la limite annoncée.
- 30 octobre 2026
Entrée en application des nouvelles conditions.
Les sources : TechCrunch pour le retrait et la déclaration de Meta, PPC Land pour l’aperçu du 18 octobre. PPC Land précise ne pas savoir quelle version a été consultée par les autres journalistes, ni si la modification vaut dans toutes les langues et toutes les régions. D’où la seule règle sûre : lire la version que votre propre compte vous demande d’accepter.
Votre entreprise est-elle concernée ?
Oui, si elle a un compte professionnel chez Meta : une page Facebook ou Instagram gérée en entreprise, des campagnes publicitaires, un catalogue ou le gestionnaire d’entreprise. La section 7 des conditions prévoit que l’usage commercial des produits de Meta après notification vaut acceptation ; l’alternative proposée est d’arrêter cet usage. Il n’existe pas de case à décocher.
Ce que la clause couvre exactement reste discuté. Meta parle de récupérer des informations exactes sur les produits vendus sur des sites tiers, ce qui sert ses publicités ; la phrase sur l’entraînement va plus loin. Pour une boutique, laisser Meta lire ses fiches produit peut servir ses campagnes. Pour un éditeur dont les articles sont le produit, la question est celle de la rémunération des auteurs par les entreprises d’IA.
Que pouvez-vous vérifier avant le 30 octobre ?
Le contrat est une chose, l’accès technique en est une autre. Meta documente ses robots d’exploration et la façon de les régler dans le fichier robots.txt :
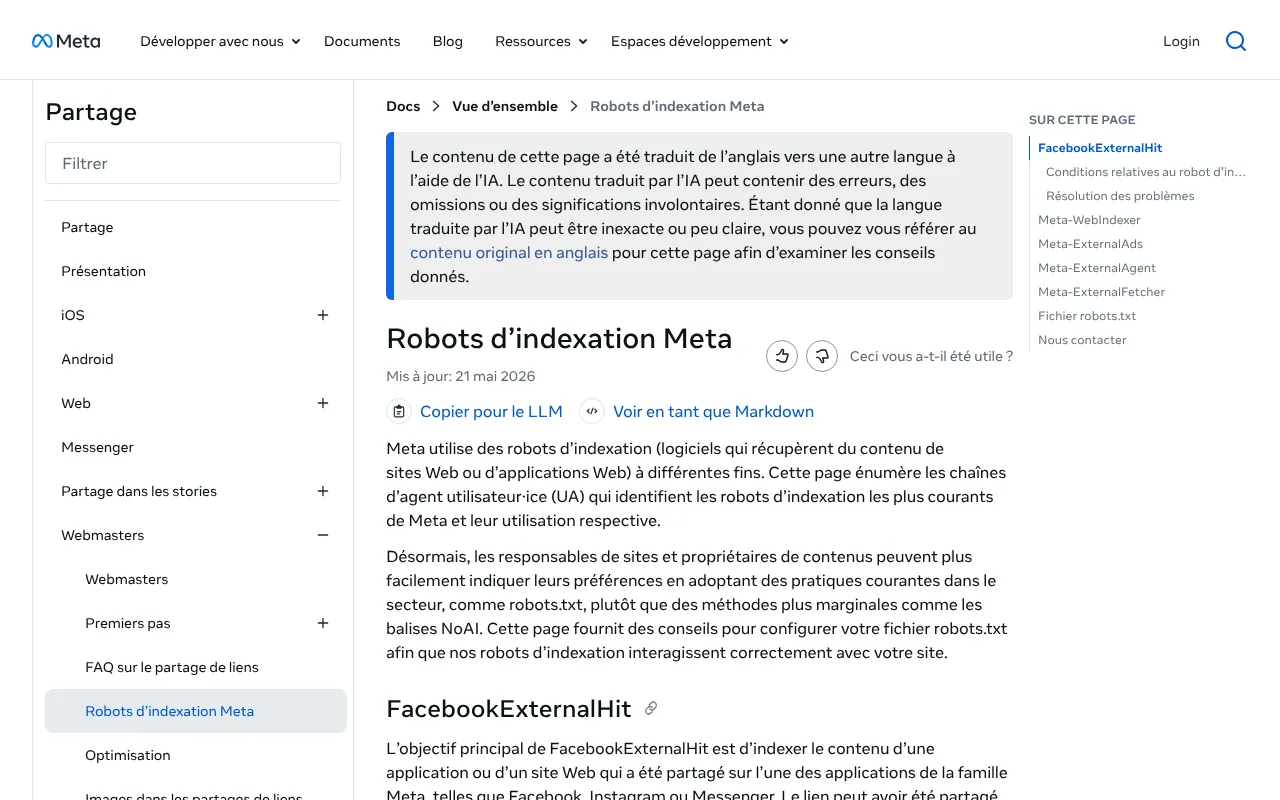
La page où Meta liste ses robots et la conduite à tenir dans le robots.txt. Capturée le 19 octobre 2026.
Cinq robots, cinq usages, selon cette page :
- FacebookExternalHit : il fabrique l’aperçu d’un lien partagé ; il peut ignorer le robots.txt pour des contrôles de sécurité ou d’intégrité.
- Meta-WebIndexer : il sert la recherche de Meta AI, pour citer vos pages avec un lien.
- Meta-ExternalAds : il sert la publicité et les produits professionnels.
- Meta-ExternalAgent : il sert à entraîner les modèles de fondation de Meta, et à indexer des contenus.
- Meta-ExternalFetcher : il va chercher un lien à la demande d’un utilisateur ; il peut lui aussi ignorer le robots.txt.
Meta précise qu’une modification du robots.txt peut mettre jusqu’à 24 heures à être prise en compte. Le geste utile n’est donc pas de tout fermer : c’est de décider, robot par robot, ce que vous ouvrez à la publicité, à la citation et à l’entraînement, comme pour les robots d’OpenAI, de Google ou d’Anthropic que nous détaillons dans comment être cité par ChatGPT. Le fichier llms.txt ne règle rien de tout cela, comme l’explique notre article sur llms.txt.
Sur le terrain
Un client l’a appris à ses dépens : lors de l’audit SEO et GEO de son site, le 22 juillet 2026, le robots.txt réellement servi commençait par un bloc ajouté par son CDN, absent du code, qui interdisait déjà le site à meta-externalagent, GPTBot, ClaudeBot, Google-Extended et plusieurs autres robots d’IA. Personne ne l’avait décidé. Ce que vous croyez avoir écrit et ce que les robots lisent peuvent différer.
Quatre vérifications, avant le 30 octobre :
- Lire le texte accepté.
Ouvrez les conditions depuis votre compte professionnel et gardez-en une copie datée.
- Lire le robots.txt servi.
Celui de l’adresse publique, CDN compris, pas celui du dépôt.
- Trancher robot par robot.
Publicité, citation, entraînement : trois décisions distinctes, à écrire dans votre charte.
- Faire valider si le contenu est votre produit.
Un éditeur, un organisme de formation ou un cabinet d’études a intérêt à un avis juridique.
Ce que ça change pour une équipe de 20 à 500 personnes
Rien d’urgent si votre site est une vitrine que vous voulez voir partout ; un vrai arbitrage si vos pages vendent du savoir. Dans les deux cas, la décision appartient au dirigeant ou au responsable marketing, pas à un réglage par défaut du CDN. C’est l’un des contrôles qu’un audit sérieux fait en premier, comme le détaille ce qu’une agence SEO IA doit livrer. Notre offre être trouvé sur Google et cité par les IA commence par là.
Ce n’est pas le seul texte qui bouge cet automne. Notre actu IA d’octobre pour les dirigeants le replace parmi les autres faits du mois, et trois échéances suivent : le marquage des images générées au 2 décembre 2026, le calendrier révisé par l’Omnibus numérique dans l’AI Act, et côté cybersécurité NIS2, toujours en attente de sa loi française.
Questions fréquentes
Meta peut-il légalement utiliser mon site pour entraîner son IA ?
La clause publiée mi-octobre le prévoit pour les sites liés à un compte professionnel, mais sa portée exacte et sa validité face au droit européen ne sont pas tranchées. En Europe, un titulaire de droits peut réserver ses contenus contre la fouille de textes par un procédé lisible par machine, dont le robots.txt. Pour un contenu à forte valeur, demandez un avis juridique.
Bloquer Meta-ExternalAgent me fait-il disparaître de Facebook ?
Non, selon la documentation de Meta. Les aperçus de liens partagés viennent de FacebookExternalHit, la publicité de Meta-ExternalAds et la recherche de Meta AI de Meta-WebIndexer. Bloquer le robot d’entraînement ne touche donc pas ces usages. Vérifiez quand même, après la modification, que vos liens partagés affichent toujours leur aperçu.
La phrase sur l’entraînement a-t-elle vraiment été retirée ?
Au 19 octobre 2026, les sources divergent. TechCrunch rapporte son retrait le 17 octobre et la précision de Meta sur les produits publicitaires ; PPC Land a relu l’aperçu le 18 et y a encore trouvé la phrase. Seule la version affichée dans votre compte fait foi : lisez-la avant le 30 octobre et conservez-en une copie.
Puis-je refuser les nouvelles conditions de Meta ?
Pas en gardant les outils. Les conditions prévoient que leur usage commercial après notification vaut acceptation, et que l’entreprise qui refuse peut cesser d’utiliser les produits de Meta à des fins professionnelles. Il n’existe pas d’option intermédiaire. Votre marge de manœuvre réelle est technique : le robots.txt de votre site, robot par robot.
Sources
- L’analyse du texte publiée par PPC Land (nouvel onglet)ppc.land
- TechCrunch pour le retrait et la déclaration de Meta (nouvel onglet)techcrunch.com
- Documente ses robots d’exploration (nouvel onglet)developers.facebook.com
Jim · fondateur de Brain Plus AI
À lire aussi en seo et visibilité dans les ia
Comprendre7 min
llms.txt : à quoi ça sert vraiment
Le fichier llms.txt promet d'aider les IA à lire votre site. Ce que dit la proposition, ce qu'on peut vérifier de son usage réel, ce qu'en disent Google, OpenAI et Anthropic, et pourquoi nous en faisons un quand même.
Prendre du recul8 min
IA et droit d'auteur : faut-il payer les auteurs ?
Piller les œuvres ou apprendre comme un lecteur ? Le droit européen et un premier jugement allemand commencent à séparer apprendre et mémoriser, et un éditeur de contenu peut déjà choisir de s'opposer à l'entraînement.
Comprendre7 min
Actu IA d'octobre 2026 : ce qui change pour les dirigeants
Nouveaux modèles chez Mistral et Google, un éditeur qui change de fournisseur, des sites qui ferment la porte aux agents, une étude française sur l'embauche des jeunes et une loi cyber encore reportée. Les faits d'octobre 2026, et ce que chacun change pour une entreprise.